
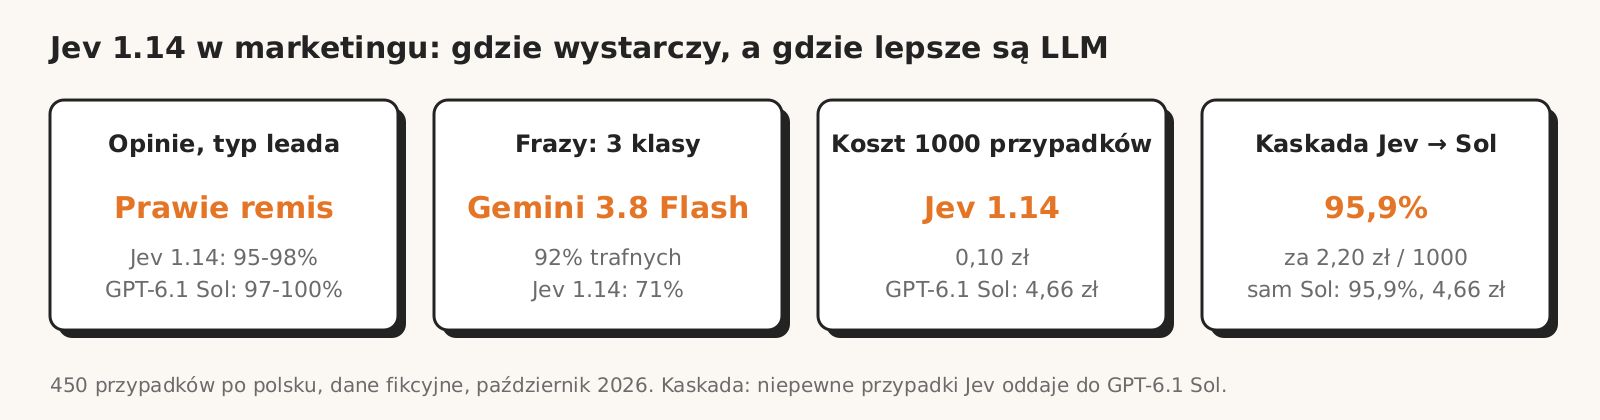
Jev 1.14 najlepiej działa w parze z modelem generatywnym. Gdy Jev decyduje tylko tam, gdzie jest pewny, a resztę oddaje GPT-6.1 Sol, trafność zostaje na poziomie samego Sola, a koszt spada o połowę.
Jev to nie czat. To model, który nie pisze tekstu, tylko odpowiada na zamknięte pytania: tak/nie z prawdopodobieństwem (Noul), wybór z listy (Choice), poziom na skali (Score), a od wersji 1.14 także ramka na obrazie (Box).
14 października TypeSafe udostępnił wersję 1.14 jako preview, w tej samej cenie co 1.13.
TypeSafe zapowiada drobne poprawki we wszystkich obszarach, najwięcej w językach innych niż angielski, oraz funkcje włączane osobnym nagłówkiem „Danger Zone”. Dzień później sprawdziliśmy je na zadaniach, które w marketingu robi się codziennie.
| Funkcja za nagłówkiem „Danger Zone” | Jev 1.13 | Jev 1.14 |
|---|---|---|
| Obrazy | tak | tak |
| Box: ramka na obrazie | nie | tak |
| Kontekst do 262 tys. tokenów | tak | tak |
Wyniki: gdzie Jev 1.14 wystarczy, a gdzie lepszy jest GPT
W sześciu zadaniach tekstowych po polsku Jev 1.14 trafił średnio w 92% przypadków, GPT-6 Luna i GPT-6.1 Sol w 96%. Różnica nie rozkłada się równo: w opiniach, kategorii leadów i weryfikacji faktów Jev jest blisko GPT, a w ocenie fraz z trzema klasami traci 15-19 punktów.
| Zadanie (PL) | Jev 1.13 | Jev 1.14 | GPT-6 Luna | GPT-6.1 Sol | Wniosek |
|---|---|---|---|---|---|
| Opinie: sentyment | 90% | 96% | 99% | 100% | 1.14 lepiej rozumie sarkazm |
| Opinie: temat, czy odpowiedzieć, sygnał zakupu | 96-98% | 96-98% | 96-99% | 99-100% | prawie remis |
| Leady: kategoria | 95% | 95% | 97% | 97% | prawie remis |
| Leady: gorącość (20 leadów od klientów) | 90% | 90% | 90% | 100% | Sol lepszy |
| Weryfikacja tekstu vs karta produktu | 97% | 97% | 100% | 100% | Jev wystarczy jako filtr |
| Intencja wyszukiwania | 100% | 96% | 100% | 99% | 1.14 słabszy od 1.13 |
| Reklamy: wszystkie ryzyka trafione | 70% | 76% | 93% | 77% | Jev 1.14 = Sol, Luna najlepsza |
| Reklamy: poprawne bez fałszywego alarmu | 88% | 96% | 96% | 88% | 1.14 rzadziej panikuje |
| Reklamy: ryzykowne wykryte | 100% | 100% | 100% | 100% | remis |
| Frazy: wyklucz czy zostaw | 92% | 93% | 96% | 99% | GPT lepszy |
| Frazy: 3 klasy (z „niejednoznaczne”) | 69% | 71% | 86% | 90% | największa słabość Jeva |
| Średnia | 91% | 92% | 96% | 96% | |
| Koszt 1000 przypadków | 0,10 zł | 0,10 zł | 0,30 zł | 4,66 zł | |
| Czas odpowiedzi (mediana) | 0,22 s | 0,22 s | 1,57 s | 2,17 s |
Trafność to odsetek przypadków, w których model dał tę samą odpowiedź co etykieta; średnia to średnia z 13 miar w tabeli. W pytaniach tak/nie liczymy „tak” przy prawdopodobieństwie powyżej 0,5. Przypadek to jedna fraza, opinia, lead, reklama albo zdanie, z 1-6 pytaniami. Koszt to cena API przeliczona po 4 zł za dolara, przy jednym wywołaniu na jeden przypadek.
Gemini 3.8 Flash przeszedł cały zestaw tylko w ocenie fraz (3 klasy: 92%, wyklucz czy zostaw: 99%), w pozostałych zadaniach skończyła nam się przedpłata w API Google, więc go w nich nie porównujemy.
Jev 1.14 vs 1.13: co się zmieniło w praktyce
Jev 1.14 jest lepszy od 1.13 średnio o 0-2 punkty: najwięcej po polsku, po hiszpańsku bez zmiany. Największe zyski są w zadaniach z niuansem: sentyment opinii po polsku z 90% do 96% i fałszywe alarmy na poprawnych reklamach po polsku z 12% do 4% (z 3 do 1 na 25 reklam).
| Zmiana 1.13 → 1.14 | PL | EN | DE | ES | UK |
|---|---|---|---|---|---|
| Średnia ze wszystkich zadań | 91% → 92% | 91% → 92% | 90% → 91% | 91% → 91% | 90% → 91% |
| Opinie: sentyment | 90% → 96% | 95% → 95% | 94% → 96% | 94% → 96% | 94% → 96% |
| Reklamy: wszystkie ryzyka trafione | 70% → 76% | 69% → 76% | 66% → 71% | 69% → 70% | 63% → 70% |
| Frazy: błędne wykluczenia | 9% → 6% | 3% → 3% | 9% → 3% | 6% → 3% | 9% → 6% |
| Intencja wyszukiwania | 100% → 96% | 98% → 96% | 96% → 98% | 99% → 98% | 99% → 98% |
| Leady: gorącość | 90% → 90% | 90% → 85% | 90% → 90% | 85% → 85% | 85% → 80% |
Błędne wykluczenie to fraza, która pasuje do oferty sklepu, a model kazał ją wykluczyć. Odsetek liczymy od 35 pasujących fraz.
Jev 1.14 wypadł gorzej od 1.13 przede wszystkim w rozpoznaniu intencji i w ocenie gorącości leadów po angielsku i ukraińsku. Mniejsze spadki są w fałszywych alarmach na reklamach po niemiecku i weryfikacji faktów po hiszpańsku. Wersja 1.14 jest też odrobinę mniej stabilna.
| Gdzie Jev 1.14 wypadł gorzej niż 1.13 | Jev 1.13 | Jev 1.14 | Spadek |
|---|---|---|---|
| Intencja wyszukiwania (PL) | 100% | 96% | większy |
| Intencja wyszukiwania (EN) | 98% | 96% | większy |
| Leady: gorącość (EN), 1 z 20 leadów | 90% | 85% | większy |
| Leady: gorącość (UK), 1 z 20 leadów | 85% | 80% | większy |
| Reklamy (DE): poprawne bez fałszywego alarmu | 88% | 84% | mniejszy |
| Weryfikacja faktów (ES) | 95% | 93% | mniejszy |
| Zmienione odpowiedzi przy powtórzeniu zapytania | 7 z 1200 | 11 z 1200 | mniej stabilny |
Jeśli masz progi pewności dostrojone pod 1.13, nie przełączaj się na alias `jev-preview` w ciemno. TypeSafe zaleca przypinanie wersji (`jev-1.13.0`, `jev-1.14.0`), bo alias zmienia model bez zmiany twojego kodu.
Języki: Jev 1.14 po polsku i ukraińsku bez wyraźnej straty
Jev 1.14 trafił 92% po polsku i angielsku oraz 91% po niemiecku, hiszpańsku i ukraińsku. Rozrzut między pięcioma językami to niecałe 2 punkty, więc dla tych zadań język nie jest problemem.
Dokumentacja TypeSafe mówi, że angielski jest głównym językiem treningu Jeva, a inne języki działają „nie równie dobrze” i trzeba je testować na własnych danych.
W naszych zadaniach różnicy nie widać, ale w całym teście instrukcje pytań były po angielsku, a treść (frazy, opinie, wiadomości) w danym języku. Wariantu z instrukcjami po polsku nie porównywaliśmy.
Słaby punkt Jeva 1.14: środek skali i marketplace'y
Jev 1.14 myli się najczęściej w ocenie fraz z trzema klasami, gdzie trafia 71% wobec 90% GPT-6.1 Sol, oraz we frazach z nazwą marketplace'u lub konkurencji.
W ocenie fraz dla sklepu rowerowego ogólne pytania typu „jaki rower do 2000 zł” czy „rower gravel czy trekking” Jev 1.14 oznaczał jako pasujące, choć to hasła informacyjne, które mogą, ale nie muszą prowadzić do zakupu.
Drugi typ błędu: frazy z nazwą marketplace'u lub konkurencji. „allegro rower górski” i „decathlon kask rowerowy” Jev 1.14 uznał za pasujące do oferty (prawdopodobieństwo „nie pasuje” 0,15 i 0,34). GPT-6.1 Sol i Gemini 3.8 Flash wyłapały wszystkie 40 niepasujących fraz.
To etykieta, z którą część specjalistów PPC by się nie zgodziła (frazy z Allegro bywają rentowne), ale model powinien ją przynajmniej oznaczyć do sprawdzenia.
W zadaniu binarnym „wyklucz czy zostaw” Jev 1.14 ma 93%. Przy progu 0,8 robi 1 błędne wykluczenie na 35 pasujących fraz, ale wyłapuje tylko 32 z 40 niepasujących, a GPT-6.1 Sol i Gemini 3.8 Flash wszystkie 40 bez błędnych wykluczeń. Jako filtr pierwszego przejścia nadaje się, jako jedyny sędzia fraz nie.
Kaskada Jev + GPT: ta sama trafność za połowę ceny
Kaskada, w której Jev 1.14 decyduje sam, gdy jest pewny, a przypadki niepewne przejmuje GPT, dała najlepszy wynik w teście. Z GPT-6.1 Sol kaskada trafiła 95,9% przy koszcie 2,20 zł za 1000 przypadków; sam Sol też 95,9%, ale za 4,66 zł.
| Wariant (PL, 450 przypadków) | Trafność | Ile przypadków idzie do GPT | Koszt 1000 przypadków |
|---|---|---|---|
| Sam Jev 1.14 | 92% | 0% | 0,10 zł |
| Jev 1.14 → GPT-6 Luna | 95,9% | 40% | 0,24 zł |
| Jev 1.14 → GPT-6.1 Sol | 95,9% | 40% | 2,20 zł |
| Sam GPT-6.1 Sol | 95,9% | 100% | 4,66 zł |
Próg pewności w kaskadzie: tak/nie poniżej 0,2 albo powyżej 0,8, wybór z listy z pewnością co najmniej 0,9. Jeśli którekolwiek pytanie w przypadku nie przechodzi progu, cały przypadek idzie do GPT.
Z tańszą GPT-6 Luną kaskada też trafia 95,9%, a koszt spada z 0,30 zł do 0,24 zł, czyli o 20%.
Kaskada działa, bo pewność Jeva 1.14 przewiduje trafność. Gdy Jev 1.14 w pytaniu z listy był pewny na co najmniej 0,99, miał rację w 99% przypadków, a tak było w 1348 z 2300 odpowiedzi we wszystkich 5 językach. Przy pewności poniżej 0,7 trafiał w 64%.
| Pewność Jeva (Choice, 5 języków) | Jev 1.13: trafność | Jev 1.14: trafność |
|---|---|---|
| poniżej 0,7 | 54% | 64% |
| 0,7-0,9 | 70% | 76% |
| 0,9-0,99 | 87% | 87% |
| 0,99 i więcej | 98% | 99% |
Jak same modele generatywne oceniały hasła na prawdziwym koncie Google Ads, opisaliśmy w teście 8 modeli AI.
Obrazy: Jev do kontroli kreacji tak, do wskazywania logo jeszcze nie
Jev 1.13 i Jev 1.14 na 48 trudnych kreacjach reklamowych poprawnie rozpoznały, czy jest przycisk CTA, cena, jaki produkt i który nagłówek, tak jak Gemini 3.8 Flash. Box, czyli wskazanie miejsca na obrazie, Jev 1.14 robi dobrze dla przycisku i ceny, ale logo trafia w 37% trudnych kreacji i 69% prostych.
| Kontrola kreacji (48 trudnych, z tłem „zdjęciowym”) | Jev 1.13 | Jev 1.14 | Gemini 3.8 Flash |
|---|---|---|---|
| Jest przycisk CTA / jest cena / produkt / nagłówek | 100% | 100% | 100% |
| Która marka (logo jako obraz wzorcowy, z logo-zmyłką) | 94% | 100% | 94% |
| W którym rogu jest logo | 88% | 88% | 98% |
| Box: przycisk CTA (średnie IoU) | brak funkcji | 0,81 | 0,97 |
| Box: cena (średnie IoU) | brak funkcji | 0,75 | 0,95 |
| Box: logo (średnie IoU / trafienia) | brak funkcji | 0,42 / 37% | 0,90 / 100% |
| Koszt 48 kreacji / czas | 0,04 zł / 0,3 s | 0,04 zł / 0,3 s | 0,77 zł / 3,2 s |
IoU to pole części wspólnej ramki modelu i prawdziwej ramki podzielone przez pole ich połączenia; 1 = idealnie, trafienie liczymy od 0,5. Kreacje wygenerowaliśmy programowo (fikcyjne marki, płaska grafika), więc znamy dokładne położenie każdego elementu.
W serii 48 prostych kreacji (jednolite tło) wyniki były podobne: nagłówek wszystkie trzy modele rozpoznały w 92%, a czytelność nagłówka przy słabym kontraście Jev ocenił trafnie w 94%, Gemini w 100%.
Praktyczne zastosowanie: wstępna kontrola wielu kreacji przed publikacją (czy jest CTA, czy logo jest właściwej marki, czy cena jest widoczna) za grosze i w ułamku sekundy. Do kadrowania czy sprawdzania pola ochronnego logo Box w 1.14 jest jeszcze za mało dokładny.
TypeSafe oznacza obrazy i Box jako jeszcze niegotowe do produkcji: format odpowiedzi i wyniki mogą się zmieniać między wersjami.
Długi kontekst w Jevie: 250 tys. tokenów opinii w 4 sekundy
Jev 1.13 i Jev 1.14 odpowiadają na pytania o 251 tys. tokenów opinii klientów w 4,2 s, Gemini 3.8 Flash w 5,2 s. Jev 1.13 znalazł wszystkie skargi bez fałszywych alarmów na każdym rozmiarze, Jev 1.14 przy 251 tys. tokenów pominął 2 z 18.
W stogu od 250 do 8400 opinii klientów ukryliśmy 6 skarg napisanych innymi słowami niż pytanie i dodaliśmy zmyłki o podobnych tematach.
| Rozmiar (opinie / tokeny) | Jev 1.13 | Jev 1.14 | Gemini 3.8 Flash |
|---|---|---|---|
| 250 / 8 tys. | 100% (0,3 s) | 100% (0,3 s) | 100% (2,5 s) |
| 2000 / 60 tys. | 100% (0,6 s) | 100% (0,7 s) | 100% (3,6 s) |
| 4000 / 119 tys. | 100% (1,5 s) | 100% (1,4 s) | 100% (3,5 s) |
| 8400 / 251 tys. | 100% (4,2 s) | 94%, 16 z 18 skarg (4,2 s) | 100% (5,2 s) |
Każdy rozmiar sprawdziliśmy na 3 losowych stogach, po 12 pytań tak/nie: 6 o skargi, które są w opiniach, i 6 o podobne, których nie ma.
Jedno zapytanie na 251 tys. tokenów kosztuje w Jevie ok. 4 grosze, w Gemini 3.8 Flash ok. 70 groszy.
Zastosowanie: pytania o całą bazę opinii, transkrypcje rozmów czy eksport zgłoszeń („czy ktoś zgłasza podwójne obciążenie karty?”). TypeSafe sam ostrzega, że długi kontekst jest wolniejszy i mniej dokładny niż praca w domyślnym limicie (64 tys. tokenów na zapytanie), i nasz wynik dla 1.14 przy 251 tys. to potwierdza.
Jak testowaliśmy Jev 1.14
Jev 1.13 i Jev 1.14 testowaliśmy na 450 przypadkach po polsku w sześciu zadaniach tekstowych, na tych samych zestawach po angielsku, niemiecku, hiszpańsku i ukraińsku, na 2 × 48 kreacjach reklamowych i na długim kontekście do 251 tys. tokenów.
Zadania i dane
Z 450 przypadków po polsku 101 oznaczyliśmy jako trudne (sarkazm, hasła podchwytliwe, półprawdy). Wszystkie firmy i marki są fikcyjne, żeby wyniki dało się opublikować bez danych klientów.
| Zadanie | Przypadki | Co model ocenia |
|---|---|---|
| Frazy wyszukiwania (sklep rowerowy) | 100 | pasuje / nie pasuje / niejednoznaczne; wykluczyć czy zostawić |
| Intencja wyszukiwania (różne branże) | 80 | informacyjna, transakcyjna, porównawcza, nawigacyjna, lokalna |
| Opinie i komentarze (kosmetyki) | 80 | sentyment, temat, czy odpowiedzieć, sygnał zakupu |
| Leady z formularza (system rezerwacji) | 60 | kategoria nadawcy, gorącość 0-2 |
| Teksty reklam | 70 | 6 ryzyk: interpunkcja, superlatyw, cudza marka, zdrowie, cena, finanse |
| Tekst marketingowy vs karta produktu | 60 | potwierdza / przeczy / karta nie mówi |
Zestawy przetłumaczyliśmy na angielski, niemiecki, hiszpański i ukraiński. Do tego 2 × 48 kreacji reklamowych (proste i trudne) oraz test długiego kontekstu.
Modele i ustawienia
Jev 1.13.0 i Jev 1.14.0 (preview) przez API TypeSafe, oba za $0,042 za milion tokenów wejścia. Porównanie: GPT-6 Luna i GPT-6.1 Sol (OpenAI) oraz Gemini 3.8 Flash (Google), z niskim poziomem rozumowania i odpowiedzią w JSON. Jev odpowiadał w 5 językach, modele GPT po polsku i angielsku.
Każde pytanie po polsku zadaliśmy Jevowi dwa razy, żeby zmierzyć stabilność, i trzeci raz z przetasowaną kolejnością opcji. Kolejność prawie nie miała znaczenia: 1.14 zmienił 5 z 460 wyborów.
Kto przygotował test
Zadania, etykiety i kod przygotował model Claude (Anthropic), który w teście nie brał udziału. Tłumaczenia zrobił GPT-6.1 Sol, czyli jeden z testowanych modeli, co mogło mu lekko pomóc w wersji angielskiej. Przypadki, w których nie dało się jednoznacznie ustalić etykiety, usuwaliśmy z zestawów; mimo to część etykiet zostaje dyskusyjna, jak frazy z Allegro.
Do czego użyć Jeva w marketingu
Jev 1.14 opłaca się już dziś w sortowaniu opinii, kwalifikacji leadów i jako filtr przed droższym modelem, a w kontroli tekstów reklam jako pierwsze sito. Jako jedyny sędzia wykluczeń w Google Ads i do wskazywania logo na kreacji lepiej poczekać.
| Zastosowanie | Werdykt | Dlaczego |
|---|---|---|
| Sortowanie opinii i komentarzy (sentyment, temat, czy odpowiedzieć) | tak | 96-98%, 0,22 s, grosze przy tysiącach komentarzy |
| Kwalifikacja leadów z formularza | tak, z kontrolą spamu | 95% kategorii; sprzedawców usług 10 z 10, spam 6 z 8 |
| Filtr przed droższym modelem (kaskada) | tak | trafność GPT za połowę kosztu |
| Kontrola tekstów reklam przed publikacją | jako pierwsze sito | wykrył wszystkie ryzykowne reklamy, ale trafia komplet ryzyk w 76% |
| Jedyny sędzia wykluczeń w Google Ads | nie | 71% w 3 klasach, marketplace'y przepuszcza |
| Box: wskazanie logo na kreacji | jeszcze nie | 37% trafień |
Jev nie liczy i nie pisze. Sumy, porównania okresów i progi wydatków zostaw kodowi, a teksty modelowi generatywnemu. Dlaczego AI myli się w liczbach z kont reklamowych, opisaliśmy we wpisie o złych liczbach AI z Google Ads.
Gratis: skrypt Google Ads, który ocenia wyszukiwane hasła Jevem
Przygotowaliśmy darmowy skrypt Google Ads, który pobiera wyszukiwane hasła z ostatnich 30 dni (do 500 najdroższych z co najmniej 1 kliknięciem), pyta Jev 1.13 o każde z nich i zapisuje propozycje wykluczeń do arkusza Google. Skrypt niczego nie zmienia na koncie: dostajesz arkusz z rekomendacjami „Wyklucz”, „Sprawdź” i „Zostaw”, a decyzję podejmujesz sam.
Pobierz skrypt jev-wykluczenia-google-ads.js.
Skrypt zadaje Jevowi dwa pytania o każde hasło: czy osoba szuka czegoś, czego nie sprzedajesz, i czy hasło zawiera nazwę innego sklepu, marketplace'u albo marki konkurencji. Drugie pytanie dodaliśmy po teście, bo frazy z Allegro i Decathlonem były słabym punktem Jeva.
| Co jest w arkuszu | Jak to liczymy |
|---|---|
| Wyklucz | Jev daje co najmniej 0,8, że hasło nie pasuje do oferty |
| Sprawdź | 0,3-0,8, albo hasło zawiera inną markę lub sklep |
| Zostaw | reszta; zawsze hasła z konwersjami i z twoją marką |
| Do listy wykluczeń | hasło w nawiasach kwadratowych, gotowe do wklejenia jako dopasowanie ścisłe |
| Koszt, kliknięcia, konwersje | suma z kampanii, w których hasło się wyświetlało |
Skrypt sprawdziliśmy na atrapie konta ze 100 frazami sklepu rowerowego z testu. W jednym zapytaniu do Jeva 34 z 40 niepasujących fraz trafiło do „Wyklucz”, 6 do „Sprawdź”, a żadna pasująca fraza nie dostała rekomendacji „Wyklucz”.
Jak uruchomić, w 5 krokach:
- 1Utwórz klucz API w konsoli TypeSafe (instrukcja w szybkim starcie TypeSafe).
- 2W Google Ads otwórz Narzędzia, potem Działania zbiorcze, potem Skrypty, i dodaj nowy skrypt.
- 3Wklej cały plik i uzupełnij sekcję USTAWIENIA: klucz Jeva, opis oferty (co sprzedajesz i czego nie) oraz nazwy twojej marki.
- 4Kliknij „Autoryzuj”, potem „Podgląd”. Link do arkusza znajdziesz w logach skryptu.
- 5Jeśli wynik ci odpowiada, ustaw harmonogram, np. raz w tygodniu.
Klucz API widzi każdy, kto ma dostęp do skryptów na koncie, więc nie udostępniaj skryptu z wpisanym kluczem. Do Jeva trafia tylko opis oferty i treść haseł, bez kosztów i danych konta. Skrypt obejmuje kampanie, które mają raport wyszukiwanych haseł (Search i Shopping), bez Performance Max.
Czego ten test nie mówi
Test Jeva 1.14 nie mówi, jak model wypada na prawdziwych danych klientów, na zdjęciach produktów, w porównaniu z GPT w innych językach niż polski i angielski ani w wersji stabilnej.
| Ograniczenie testu | Co może zmienić wynik |
|---|---|
| Dane są fikcyjne, a etykiety przygotował jeden autor (model) | część etykiet jest sporna, np. frazy z Allegro |
| Kreacje to płaska grafika z generatora, nie zdjęcia | na zdjęciach produktów Box może wypaść inaczej |
| Modele GPT tylko po polsku i angielsku, Gemini 3.8 Flash tylko na frazach, obrazach i długim kontekście | brak porównania z Jevem w pozostałych językach i zadaniach |
| Jedno wywołanie API na jeden przypadek | Jev pozwala zadać wiele pytań w jednym wywołaniu, co obniża koszt jeszcze bardziej |
| Jev 1.14 to preview z 14 października 2026 | wynik może się zmienić przed wersją stabilną |
Co z tego bierzemy do Marketing Workspace
W Marketing Workspace, naszym asystencie AI do kont Google Ads, Meta Ads i GA4, Jev (TypeSafe) rozpoznaje rodzaj pytania i kieruje je dalej jako pierwsze sito, a właściwą odpowiedź przygotowuje mocniejszy model; liczby zawsze liczy kod. Jev dostaje wyłącznie treść pytania, przez płatne API TypeSafe, bez trenowania na danych i na umowie powierzenia, tak jak pozostali nasi dostawcy AI.
Takie testy robimy, bo w Marketing Workspace dobieramy model osobno do każdej pracy, zamiast używać jednego do wszystkiego.
Jeśli chcesz zobaczyć, jak to działa na twoim koncie, Marketing Workspace ma miesiąc za darmo.
Założyciel Roition, niezależny developer Google Ads API
Założyciel Roition, prawie 3 lata doświadczenia w Google Ads. Projektuje i wdraża automatyzacje procesów dla polskich firm: integracje systemów, obsługę zapytań i ofert, asystentów AI pracujących na danych firmy.
Najczęstsze pytania
Czym jest Jev?
Model AI firmy TypeSafe, który nie generuje tekstu, tylko odpowiada na zamknięte pytania: tak/nie z prawdopodobieństwem, wybór z listy, poziom na skali, a od 1.14 ramka na obrazie. Kosztuje $0,042 za milion tokenów wejścia, wyjście jest darmowe.
Co nowego w Jev 1.14?
Box, czyli ramka na obrazie, której 1.13 nie ma, i lepszy sentyment opinii po polsku (96% vs 90%). Wersja 1.14 wyszła 14 października jako preview, w tej samej cenie co 1.13. Obrazy i kontekst do 262 tys. tokenów działają w obu wersjach po włączeniu nagłówka „Danger Zone”.
Czy Jev 1.14 jest lepszy od 1.13?
O 0-2 punkty w naszych zadaniach (po polsku 92% vs 91%), najwięcej w sentymencie opinii po polsku (96% vs 90%). Gorzej wypadł w intencji wyszukiwania (po polsku 96% vs 100%) i jest trochę mniej stabilny.
Czy Jev działa po polsku?
Tak. W naszym teście trafił 92% po polsku i 91-92% w pozostałych czterech językach, przy instrukcjach pytań po angielsku.
Czy Jev zastąpi GPT albo Gemini?
W decyzjach tak/nie i prostych klasyfikacjach prawie tak, w ocenach ze środkiem skali nie: frazy w 3 klasach 71% vs 90% GPT-6.1 Sol. Średnio 92% vs 96%. Najlepiej sprawdza się jako pierwsze sito, które oddaje niepewne przypadki mocniejszemu modelowi.
Ile kosztuje Jev w praktyce?
W naszym teście 0,10 zł za 1000 przypadków przy jednym wywołaniu na przypadek, wobec 0,30 zł dla GPT-6 Luna i 4,66 zł dla GPT-6.1 Sol.
Jak szybko odpowiada Jev?
W naszym teście mediana czasu odpowiedzi Jeva 1.13 i 1.14 to 0,22 s, wobec 1,57 s GPT-6 Luna i 2,17 s GPT-6.1 Sol. Zapytanie na 251 tys. tokenów opinii trwało 4,2 s.
Jak połączyć Jev z GPT w kaskadę?
Jev 1.14 odpowiada sam, gdy pytanie tak/nie ma prawdopodobieństwo poniżej 0,2 albo powyżej 0,8, a wybór z listy pewność co najmniej 0,9. Gdy którekolwiek pytanie w przypadku nie przechodzi progu, cały przypadek przejmuje GPT. W naszym teście do GPT trafiło 40% przypadków, a trafność wyniosła 95,9%.
Czy Jev nadaje się do wykluczania fraz w Google Ads?
Jako filtr pierwszego przejścia tak, jako jedyny sędzia nie. W „wyklucz czy zostaw” Jev 1.14 ma 93%, w 3 klasach 71%, a frazy typu „allegro rower górski” uznał za pasujące.
Czy Jev rozpoznaje elementy na kreacjach reklamowych?
Tak: na 48 trudnych kreacjach Jev 1.13 i 1.14 rozpoznały przycisk CTA, cenę, produkt i nagłówek w 100%. Box w 1.14 wskazuje przycisk i cenę dobrze, logo trafia w 37% trudnych kreacji. TypeSafe oznacza obrazy i Box jako niegotowe do produkcji.
Ile tekstu Jev przeczyta w jednym zapytaniu?
Domyślnie 64 tys. tokenów, a po włączeniu nagłówka „Danger Zone” do 262 tys. tokenów w 1.13 i 1.14. Przy 251 tys. tokenów Jev 1.13 znalazł wszystkie skargi, Jev 1.14 pominął 2 z 18.
Czy jest gotowe narzędzie do oceny haseł Jevem?
Tak, nasz darmowy skrypt Google Ads (sekcja „Gratis” wyżej) ocenia wyszukiwane hasła z ostatnich 30 dni i zapisuje rekomendacje do arkusza Google. Niczego nie zmienia na koncie. Potrzebujesz tylko własnego klucza API TypeSafe.
Czy Jev 1.14 nadaje się do produkcji?
To preview z 14 października 2026, więc wynik może się zmienić przed wersją stabilną. TypeSafe zaleca przypinanie wersji (`jev-1.14.0`) zamiast aliasu `jev-preview`, a obrazy i Box oznacza jako jeszcze niegotowe do produkcji.