
Sprawdziliśmy też samych sędziów: dwóch z trzech sędziów-modeli zawyżało oceny modeli własnej firmy, a w ślepej ocenie praktyka Claude Opus 5.5 wygrał 8 z 10 par.
Test zrobiliśmy na początku października 2026, bo pracując z AI na kontach Google Ads ciągle trafialiśmy na ucięte wyniki i halucynacje, czyli odpowiedzi, które brzmią pewnie, a nie mają pokrycia w danych. Skąd się biorą, opisujemy we wpisie o złych liczbach z Google Ads. Zamiast pytać, który model jest najlepszy, zapytaliśmy: najlepszy do czego.
Wyniki: Claude, GPT czy Gemini, który model AI wygrał które zadanie w Google Ads
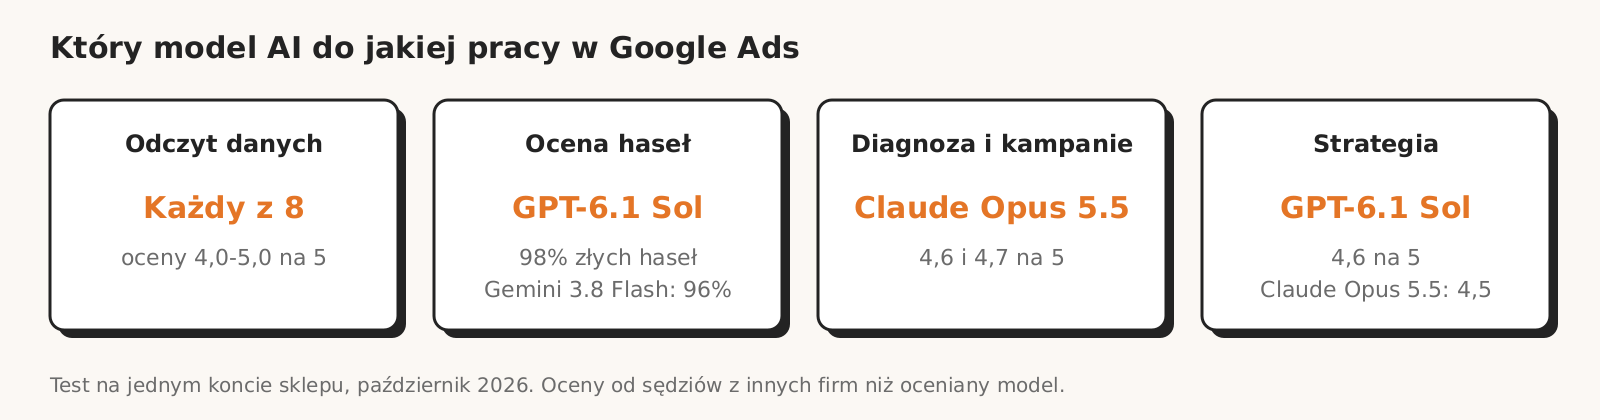
W teście 8 modeli AI na koncie Google Ads w diagnozie, optymalizacji i projektach kampanii prowadził Claude Opus 5.5, w strategii GPT-6.1 Sol, a hasła do wykluczenia najlepiej oceniły GPT-6.1 Sol i Gemini 3.8 Flash.
| Praca na koncie | Najlepsze modele | Najsłabsze modele | Wniosek |
|---|---|---|---|
| Odczyt danych (koszty, konwersje) | Gemini 3.8 Flash: 5,0; Claude Sonnet 5.5: 4,9 | Gemini 3.5 Flash-Lite: 4,0 | różnice małe, wszystkie 4,0-5,0 na 5 |
| Ocena 200 haseł: czy wykluczyć | GPT-6.1 Sol: 98% złych haseł wyłapanych; Gemini 3.8 Flash: 96% (wykluczył też 21 haseł niejednoznacznych); oba bez błędnych wykluczeń | Gemini 3.5 Flash-Lite: 65% i 1 błędne wykluczenie; Claude Haiku 4.5: 72%; GPT-6 Luna wyłapała 94%, ale z 2 błędnymi wykluczeniami | rozrzut ponad 30 punktów procentowych |
| Diagnoza i optymalizacja | Claude Opus 5.5: 4,6 (diagnoza) i 4,5 (optymalizacja) | Claude Haiku 4.5: 2,9 i 1,9 | prowadzi Opus, drugi model 0,1-0,2 pkt niżej |
| Strategia (audyt konta, sezon, plan na 3 miesiące) | GPT-6.1 Sol: 4,6; Claude Opus 5.5: 4,5 | Claude Haiku 4.5: 2,2 | prawie remis Sola i Opusa; Gemini 3.8 Flash, najlepszy w odczycie, tu ma 3,5 |
| Projekt kampanii (Search, PMax, Shopping) | Claude Opus 5.5: 4,7; GPT-6.1 Sol: 4,6 | Claude Haiku 4.5: 2,3 | Gemini 3.8 Flash znów wyraźnie słabszy: 3,6 |
| Ślepa ocena przez praktyka | Claude Opus 5.5: 8 wygranych w 10 parach | nie dotyczy | praktyk widział różnice tam, gdzie sędziowie-modele widzieli remis |
Oceny 1-5 to średnie ocen sędziów z innych firm niż oceniany model. Ocena haseł objęła sześć modeli, bez Claude Opus 5.5 i Gemini 3.1 Pro.
Ocena haseł to 200 wyszukiwanych haseł z raportu tego konta. Każde miało etykietę: 83 nie pasują do oferty, 21 pasuje, a 96 jest niejednoznacznych, czyli ogólnych, jak „zabawki dla 3 latka”. „Złe hasła wyłapane” to odsetek z 83 niepasujących, które model kazał wykluczyć. Błędne wykluczenie to wykluczenie hasła pasującego. Wykluczenie niejednoznacznego nie jest błędem, ale grozi utratą ruchu.
Pełne wyniki 8 modeli AI w Google Ads: oceny i czas odpowiedzi
W pełnych wynikach 8 modeli AI w Google Ads tylko Claude Opus 5.5 i GPT-6.1 Sol mają we wszystkich pięciu poziomach zadań co najmniej 4,2 na 5. Najszybciej odpowiadały Gemini 3.5 Flash-Lite (7 s) i Claude Haiku 4.5 (10 s), które w wyniku łącznym zajęły dwa ostatnie miejsca.
| Model | Odczyt | Diagnoza | Optymalizacja | Strategia | Projekt kampanii | Hasła: złe wyłapane / błędne wykluczenia | Czas odpowiedzi (mediana) |
|---|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 4,8 | 4,6 | 4,5 | 4,5 | 4,7 | nie testowany | 64 s |
| Gemini 3.8 Flash | 5,0 | 4,3 | 4,0 | 3,5 | 3,6 | 96% / 0 | 26 s |
| GPT-6.1 Sol | 4,5 | 4,4 | 4,2 | 4,6 | 4,6 | 98% / 0 | 18 s |
| Claude Sonnet 5.5 | 4,9 | 4,3 | 4,4 | 4,0 | 4,1 | 93% / 0 | 30 s |
| Gemini 3.1 Pro (preview) | 4,8 | 3,4 | 3,1 | 3,2 | 2,8 | nie testowany | 22 s |
| GPT-6 Luna | 4,2 | 3,5 | 3,8 | 4,0 | 3,4 | 94% / 2 | 20 s |
| Gemini 3.5 Flash-Lite | 4,0 | 3,4 | 3,3 | 2,9 | 3,0 | 65% / 1 | 7 s |
| Claude Haiku 4.5 | 4,6 | 2,9 | 1,9 | 2,2 | 2,3 | 72% / 0 | 10 s |
Kolejność według wyniku łącznego z ocen krzyżowych. Czas to mediana czasu odpowiedzi w zadaniach opisowych.
Najważniejszy wniosek praktyczny: jeśli do wszystkiego używasz jednego modelu, w zwykłym czacie albo w jednym skrypcie, część zadań wykonuje u ciebie model, który właśnie w tych zadaniach wypadł słabiej od innych.
Jak testowaliśmy modele AI na koncie Google Ads
Osiem modeli AI od Anthropic, OpenAI i Google dostało ten sam pakiet danych z prawdziwego konta Google Ads i 17 pytań na pięciu poziomach trudności, a odpowiedzi oceniało trzech sędziów-modeli z różnych firm.
Na jakich danych testowaliśmy
Testowaliśmy na prawdziwym koncie Google Ads małego sklepu internetowego, z jedną główną kampanią produktową. Nie podajemy nazwy ani liczb sprzedażowych. Każdy model dostał ten sam pakiet: opis klienta i jego celów oraz wyniki 25 zapytań do API Google Ads, czyli raportów pobranych z konta. Do tego ten sam prompt, ten sam poziom rozumowania i ten sam limit długości odpowiedzi.
Które modele AI testowaliśmy
Anthropic: Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 4.5. OpenAI: GPT-6.1 Sol, GPT-6 Luna (te same modele działają w ChatGPT, ale w czacie z innymi ustawieniami niż w naszym teście). Google: Gemini 3.1 Pro (wersja preview), Gemini 3.8 Flash, Gemini 3.5 Flash-Lite.
Jakie zadania dostały modele
17 pytań na pięciu poziomach trudności. Dwa dodatkowe pytania z wiedzy ogólnej odrzuciliśmy, bo przy instrukcji „używaj wyłącznie danych” wszystkie modele odmawiały odpowiedzi.
| Poziom | Przykład pytania |
|---|---|
| Odczyt | Ile kosztowała kampania i ile miała konwersji w ostatnich 30 dniach? |
| Diagnoza | Dlaczego kampania nie osiąga celu? |
| Optymalizacja | Znajdź słowa kluczowe do wykluczenia |
| Strategia | Przygotuj plan na 3 miesiące, żeby kampania doszła do docelowego ROAS |
| Projekt kampanii | Zaprojektuj kampanię Search, Performance Max albo Shopping |
Osobna część sprawdzała decyzje tak/nie: ocenę 200 wyszukiwanych haseł z konta (wykluczyć czy zostawić), rozpoznanie typu pytania i wychwytywanie prób wstrzyknięcia poleceń. Typ pytania sześć modeli z tej części rozpoznawało poprawnie w 86-93% przypadków, a próby wstrzyknięcia poleceń wychwyciły wszystkie.
Jak ocenialiśmy odpowiedzi
Odpowiedzi oceniało trzech sędziów-modeli, każdy z innej firmy: Claude Opus 5.5, GPT-6.1 Sol i Gemini 3.1 Pro. Skala 1-5 dla pięciu kryteriów: poprawność (zgodność z danymi, brak zmyśleń), kompletność, trafność rekomendacji dla tego konta, użyteczność (czy da się od razu wdrożyć) i język.
Część rzeczy sprawdzał kod, nie sędzia: czy padły liczby, o które pytano, czy nagłówki reklam mieszczą się w limicie znaków, czy model nie wykluczył marki sklepu.
Kto przygotował test
Prompt, zadania i kryteria przygotował model Claude, czyli jeden z testowanych dostawców. Dlatego oceny modeli własnej firmy sędziego wyłączyliśmy z rankingu, sprawdziliśmy wpływ długości odpowiedzi na ocenę i dodaliśmy ślepą ocenę człowieka. Sędziowie Opus i Sol lekko karali długie odpowiedzi, Gemini lekko je nagradzał; po korekcie na długość kolejność modeli się nie zmieniła.
W audycie znaleźliśmy i poprawiliśmy dwa błędy w kontrolach kodem: kontrola faktów zaniżała oceny dwóch modeli OpenAI, a wykrywanie marki w wykluczeniach na początku fałszywie oznaczało też Claude Opus 5.5 i GPT-6.1 Sol.
Dwóch z trzech sędziów-modeli zawyżało oceny modeli własnej firmy
W naszym teście modeli AI na koncie Google Ads dwóch z trzech sędziów-modeli, Claude Opus 5.5 i GPT-6.1 Sol, podnosiło oceny modelom własnej firmy o ok. 0,5-0,8 punktu w skali 1-5. Sprawdziliśmy to, zanim policzyliśmy ranking.
Trzeci, Gemini 3.1 Pro, nie faworyzował swoich, ale był łagodny: Claude Opus 5.5 dostał od niego 5 na 5 we wszystkich zadaniach.
| Oceniany model | Sędzia Claude Opus 5.5 | Sędzia GPT-6.1 Sol | Sędzia Gemini 3.1 Pro |
|---|---|---|---|
| Claude Opus 5.5 | 4,87 (własna firma) | 4,12 | 5,00 |
| GPT-6.1 Sol | 4,11 | 4,61 (własna firma) | 4,43 |
Średnie wszystkich ocen w skali 1-5, także ocen modeli własnej firmy, których w rankingu nie liczymy.
Dlatego w rankingu liczą się tylko oceny krzyżowe: model oceniają wyłącznie sędziowie z innych firm. Każdy sędzia miał też inną skalę, więc wyniki normalizowaliśmy osobno dla każdego z nich.
Wniosek dla każdego, kto czyta rankingi narzędzi AI: sprawdź, kto oceniał. Jeśli model ocenia sam siebie albo modele tej samej firmy, wynik może być zawyżony. U nas robiło tak dwóch z trzech sędziów.
Proste pytanie nie pokaże różnicy między modelami AI
Przy odczycie liczb z konta Google Ads różnica między najlepszym a najsłabszym modelem AI to jeden punkt w skali 1-5, a przy optymalizacji, strategii i projektach kampanii ponad dwa.
| Poziom | Najsłabszy wynik | Najlepszy wynik | Różnica |
|---|---|---|---|
| Odczyt danych | 4,0 (Gemini 3.5 Flash-Lite) | 5,0 (Gemini 3.8 Flash) | 1,0 |
| Diagnoza | 2,9 (Claude Haiku 4.5) | 4,6 (Claude Opus 5.5) | 1,7 |
| Optymalizacja | 1,9 (Claude Haiku 4.5) | 4,5 (Claude Opus 5.5) | 2,6 |
| Strategia | 2,2 (Claude Haiku 4.5) | 4,6 (GPT-6.1 Sol) | 2,4 |
| Projekt kampanii | 2,3 (Claude Haiku 4.5) | 4,7 (Claude Opus 5.5) | 2,4 |
Średnie ocen krzyżowych (model oceniają tylko sędziowie z innych firm), skala 1-5.
Claude Haiku 4.5 poprawnie podał wszystkie liczby, o które pytaliśmy w zadaniach odczytu, a w projekcie kampanii Search zaproponował wykluczenie marki sklepu.
Pytanie „pokaż koszty z wczoraj” sprawdza więc tylko, czy narzędzie ma dostęp do danych. O jakości mówi dopiero trudne pytanie z konta, które dobrze znasz.
Praktyk widział różnice tam, gdzie sędziowie-modele widzieli remis
W ślepej ocenie 16 par odpowiedzi modeli AI z testu na koncie Google Ads Robert Szymański, założyciel Roition, wcześniej specjalista performance w agencji, wybrał Claude Opus 5.5 w 8 z 10 par, w których ten model wystąpił. Nie wiedział, który model napisał którą odpowiedź.
Claude Opus 5.5 wystąpił w 10 parach: wygrał 8, raz był remis, a raz obie odpowiedzi w parze oceniający uznał za niesatysfakcjonujące. W pięciu z tych wygranych sędziowie-modele widzieli remis.
Co praktyk zapisał w uwagach:
- najlepsza była odpowiedź, która sama przeliczyła dane i zauważyła zdublowaną konwersję (ten sam dzień, ta sama kwota),
- użytkownik ma widzieć nazwy kampanii i produktów, nie ich identyfikatory,
- przy wykluczeniach oczekiwał list pogrupowanych tematycznie z kosztem każdej frazy. W dwóch z czterech par o wykluczeniach uznał obie odpowiedzi za niesatysfakcjonujące, bo brakowało w nich fraz.
Sędzia GPT-6.1 Sol obniżał za to oceny odpowiedziom, które kwestionowały poprawność pomiaru konwersji. Praktyk cenił je najbardziej.
Zastrzeżenie: jedna osoba i 16 par. Część oceny to styl, który oceniający zna z codziennej pracy z modelami Claude, a odpowiedzi Opusa były najdłuższe. To wskazówka, nie dowód.
Każdy model AI się mylił, tylko w innym miejscu
W teście 8 modeli AI na koncie Google Ads nie było modelu bez błędów. Najsłabszy, Claude Haiku 4.5, dopisał do reklamy darmową dostawę, której nie było ani w danych, ani w opisie klienta, i w projekcie kampanii Search zaproponował wykluczenie marki sklepu.
Najlepsze modele robiły błędy subtelniejsze: wykluczały ogólne frazy, które blokują też hasła sprzedające, albo proponowały mocne zmiany stawek na podstawie kilku kliknięć (np. korektę stawki na urządzeniu o 70-100% na podstawie 5-7 kliknięć).
Claude Opus 5.5, lider diagnozy i projektów kampanii, też ma wady. Pisał najdłuższe i najwolniejsze odpowiedzi: mediana 64 sekund, wobec 18 sekund GPT-6.1 Sol. Proponował też wykluczenia blokujące trafny ruch i ustawienia, których w danym typie kampanii już nie ma.
Błędy AI w Google Ads, które powtarzały się u wielu modeli
Każdy z ośmiu modeli AI popełnił w Google Ads co najmniej jeden z sześciu powtarzalnych błędów, m.in. wykluczenia blokujące trafny ruch i wnioski mocniejsze niż dane.
| Błąd | Przykład | U których modeli |
|---|---|---|
| Wykluczenia blokujące trafny ruch | wykluczenie ogólnej frazy, np. „dla dzieci”, która blokuje też hasła pasujące do oferty | Claude (Opus, Sonnet, Haiku), GPT-6 Luna, Gemini 3.8 Flash |
| Wnioski mocniejsze niż dane | korekta stawki na urządzeniu o 70-100% na podstawie 5-7 kliknięć | wszystkie, najmocniej GPT-6.1 Sol i Gemini 3.8 Flash |
| Zakładanie danych, których nie ma | „korekty stawek wynoszą 0%”, gdy dane tego nie pokazywały | Claude Opus i Sonnet, Gemini 3.8 Flash |
| Nieaktualna wiedza o Google Ads | ustawienia, których już nie ma w danym typie kampanii, np. ECPC w standardowej kampanii Shopping | Claude Opus, Sonnet i Haiku |
| Brak sumowania | ten sam produkt pod dwoma tytułami liczony jako dwa różne | Gemini 3.8 Flash, Gemini 3.5 Flash-Lite, Claude Haiku |
| Rekomendacja sprzeczna z celem | zwiększenie budżetu przy wyniku daleko poniżej celu klienta | Gemini 3.1 Pro, Gemini 3.5 Flash-Lite, Claude Haiku |
Sam wybór modelu nie zapewni więc jakości. Musi ją pilnować system wokół niego: kod, który liczy, i kontrole, które sprawdzają propozycje przed pokazaniem ich człowiekowi.
Co test modeli AI zmienia w Marketing Workspace
Po teście modeli AI Marketing Workspace w najbliższym wydaniu przeniesie ocenę, czy hasło pasuje do oferty, z Claude Haiku 4.5 na Gemini 3.8 Flash. Test potwierdził też dwie wcześniejsze zmiany: osobny model dla każdej pracy i liczenie wykluczeń kodem.
Marketing Workspace, nasz asystent AI do kont Google Ads, Meta Ads i GA4, przypisuje każdej pracy osobny model AI, wykluczenia liczy kodem i sprawdza, czy liczby w odpowiedzi mają źródło w danych z konta.
Dziś korzysta z modeli Claude (Anthropic), a od października 2026 także z modeli Google (Gemini) i zapasowo OpenAI, zawsze przez płatne API, bez trenowania na danych klientów. Każdego nowego dostawcę dopuszczamy do danych klientów dopiero wtedy, gdy jego płatne API nie trenuje na danych i działa na umowie powierzenia danych. Co sprawdzić, zanim sam wkleisz dane klienta do czatu, opisujemy we wpisie o danych klienta w czacie AI.
Podział pracy między modele i kontrolę wiarygodności wprowadziliśmy 29 września, przed testem. Liczenie wykluczeń kodem weszło 7 października, w dniu zamknięcia raportu z testu. Test potwierdził kierunek obu zmian.
Co już działa:
- Każda praca ma swój model. Dane z konta zbiera Claude Sonnet 5.5, a diagnozę i propozycje pisze Claude Opus 5.5, który wygrał ślepą ocenę praktyka.
- Wykluczenia liczy system, nie model. Przy szukaniu słów do wykluczenia dane z konta pobiera i liczy kod, a model ocenia tylko, czy hasło pasuje do oferty. Hasła z konwersjami i słowa marki zapisane w karcie klienta nigdy nie trafiają na listę.
- Kontrola wiarygodności odpowiedzi. System sprawdza, czy asystent pobrał dane z konta i czy liczby w odpowiedzi mają w nich źródło. Gdy nie, widzisz ostrzeżenie.
Co zmieniamy po teście: ocenę, czy hasło pasuje do oferty, robi dziś w MW Claude Haiku 4.5. Sam model wyłapał w teście 72% złych haseł. Gemini 3.8 Flash wyłapał 96%, bez błędnych wykluczeń.
Płatne API Gemini działa na umowie powierzenia danych Google i według warunków Google nie służy do trenowania modeli.
Nad czym pracujemy: sumowanie produktów po identyfikatorze w kodzie, listy wykluczeń pogrupowane tematycznie z kosztem każdej frazy i odpowiedzi bez identyfikatorów kampanii i produktów, tylko z nazwami.
Wszystkie wydania opisujemy w publicznym dzienniku zmian Marketing Workspace, a działanie kontroli w opisie wiarygodności odpowiedzi.
Czego ten test modeli AI nie mówi
Wynik testu modeli AI w Google Ads ma pięć ograniczeń.
- Jedno konto. Mały sklep, głównie kampania produktowa. Duże konta, generowanie leadów i kampanie Search mogą dać inny wynik.
- Każdy model odpowiedział raz. Losowości odpowiedzi nie zmierzyliśmy.
- Te same dane dla wszystkich. Test nie mierzy, jak model sam zbiera dane z konta. To osobna umiejętność. Co idzie źle, gdy AI dostaje dane niepełne albo nie pobiera ich wcale, opisujemy we wpisie o złych liczbach z Google Ads.
- Etykiety haseł ustalił model Claude. Najbardziej zgadzał się z nimi GPT-6.1 Sol, a modele Claude słabiej, więc w ocenie haseł nie widać przewagi Claude'a. Sporne hasła i tak wymagają oceny człowieka.
- Wersje z października 2026. Modele zmieniają się co kilka miesięcy; wynik dotyczy wersji, które testowaliśmy.
Zobacz, jak działa Marketing Workspace
Założyciel Roition, niezależny developer Google Ads API
Założyciel Roition, prawie 3 lata doświadczenia w Google Ads. Projektuje i wdraża automatyzacje procesów dla polskich firm: integracje systemów, obsługę zapytań i ofert, asystentów AI pracujących na danych firmy.
Najczęstsze pytania
Który model AI jest najlepszy do Google Ads?
To zależy od pracy. W naszym teście diagnozę i projekty kampanii najlepiej robił Claude Opus 5.5, strategię GPT-6.1 Sol (4,6 wobec 4,5), a hasła najlepiej oceniły GPT-6.1 Sol i Gemini 3.8 Flash. Za odczyt każdy model dostał 4,0-5,0. Wynik pochodzi z jednego konta.
Który model AI najlepiej wybiera wykluczające słowa kluczowe?
W ocenie 200 wyszukiwanych haseł z konta GPT-6.1 Sol wyłapał 98% złych haseł, a Gemini 3.8 Flash 96%, oba bez błędnych wykluczeń. Claude Haiku 4.5 wyłapał 72%. Sporne, ogólne hasła i tak wymagają oceny człowieka.
Czy ChatGPT nadaje się do pracy na koncie Google Ads?
Testowane GPT-6.1 Sol i GPT-6 Luna działają też w ChatGPT, ale tam z innymi ustawieniami niż w teście. GPT-6.1 Sol wygrał strategię (4,6 na 5) i ocenę haseł (98%), a GPT-6 Luna w diagnozie, optymalizacji, strategii i projektach dostała 3,4-4,0.
Czy Gemini nadaje się do Google Ads?
Zależy od wersji. Gemini 3.8 Flash dostał 5,0 za odczyt i wyłapał 96% złych haseł, ale w strategii (3,5) i projektach kampanii (3,6) był słabszy od Opusa i Sola. Gemini 3.1 Pro (preview) w diagnozie, optymalizacji, strategii i projektach dostał 2,8-3,4.
Który model AI odpowiada najszybciej?
W naszym teście Gemini 3.5 Flash-Lite (mediana 7 s) i Claude Haiku 4.5 (10 s), ale w wyniku łącznym zajęły dwa ostatnie miejsca. Z czołówki najszybszy był GPT-6.1 Sol (18 s), a najwolniejszy Claude Opus 5.5 (64 s).
Czy mogę ufać rankingom modeli AI w internecie?
Sprawdź, kto oceniał. W naszym teście dwóch z trzech sędziów-modeli zawyżało oceny modeli własnej firmy.
Jak samemu sprawdzić narzędzie AI do kont reklamowych?
Zadaj mu jedno trudne pytanie z konta, które znasz najlepiej, np. „które hasła wykluczyć i czego nie ruszać”, i oceń odpowiedź tak, jak oceniasz pracę nowego specjalisty.
Czy model AI sam pobierze dane z konta Google Ads?
Nie, dopóki nie połączysz go z kontem, np. przez konektor, API albo narzędzie, które to robi. Tego nasz test nie mierzył: wszystkie modele dostały te same dane.
Na jakim modelu działa Marketing Workspace?
Na modelach Claude (Anthropic), a od października 2026 także Gemini (Google) i zapasowo OpenAI, zawsze przez płatne API, bez trenowania na danych klientów.